
Appearance
数据结构&排序算法
数据结构决定了数据「如何组织与存取」,算法决定了数据「如何被高效处理」。本篇从线性结构(数组/栈/队列/链表)到非线性结构(树/哈希表),再到经典排序与搜索算法,配合复杂度对比与图解,帮助你建立「用合适的结构解决对应问题」的工程直觉与面试知识体系。
导航目录
一、数据结构篇
二、排序算法篇
三、搜索算法篇
数据结构总览
核心概念:如何选择数据结构?
数据结构的选择本质是一场「时间 vs 空间」「查找快 vs 增删快」的权衡。没有最优的结构,只有最适合当前场景的结构。
各数据结构核心操作的平均时间复杂度对比:
| 数据结构 | 访问 | 查找 | 插入 | 删除 | 特点 |
|---|---|---|---|---|---|
| 数组 Array | O(1) | O(n) | O(n) | O(n) | 随机访问快,增删需位移 |
| 栈 Stack | O(n) | O(n) | O(1) | O(1) | 后进先出 LIFO |
| 队列 Queue | O(n) | O(n) | O(1) | O(1) | 先进先出 FIFO |
| 链表 LinkedList | O(n) | O(n) | O(1) | O(1) | 增删快,无需连续内存 |
| 哈希表 HashTable | — | O(1) | O(1) | O(1) | 键值映射,查找最快 |
| 二叉搜索树 BST | O(log n) | O(log n) | O(log n) | O(log n) | 有序,需保持平衡 |
数组
功能说明:数组是一种线性的数据结构,用于存储相同类型的元素集合。
核心概念:为什么数组随机访问快?
数组在内存中占用一段连续空间,元素地址 = 首地址 + 索引 × 元素大小,因此可通过索引一步定位(O(1))。代价是增删中间元素时后续元素都要整体位移(O(n)),且扩容需要重新申请更大连续空间并拷贝。
- 优点: 查找特定的元素特别快,通过索引下标查找元素,时间复杂度 O(1)
- 缺点: 需要在内存中开辟连续的空间,当达到上限的时候,需要开辟 2 倍的空间,再把之前的数组拷贝过去;在头部增加、删除元素特别慢,因为每一个元素都需要位移
栈
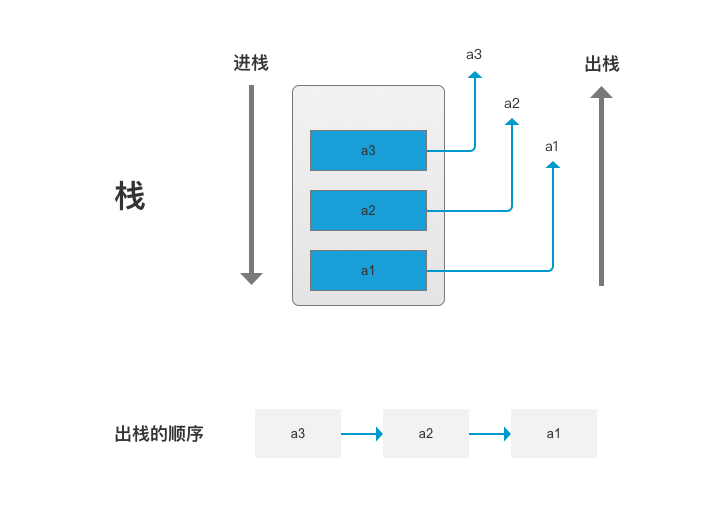
功能说明:栈是一种受限的数据结构,遵循后进先出(LIFO)原则,只能从栈顶一端进行操作。
核心概念:栈的典型应用
栈的「后进先出」特性天然适合处理具有嵌套/回溯语义的场景:函数调用栈、括号匹配、表达式求值、浏览器前进后退、进制转换、DFS 递归等。凡是「最后发生的最先处理」的问题,都可以考虑用栈。
- 实现方式:可以用数组或者链表来实现
- 特点:后进的先出,分为进栈和出栈,只能从栈顶一端进行操作,不能跨级
js
class Stack {
  constructor() {
    this.items = [];
  }
  // 进栈
  push(element) {
    this.items.push(element);
  }
  // 出栈
  pop() {
    return this.items.pop();
  }
  // 查看栈顶元素
  peek() {
    return this.items[this.items.length - 1];
  }
  // 获取栈中元素的个数
  size() {
    return this.items.length;
  }
  // 判断栈中的元素是否为空
  isEmpty() {
    return this.items.length === 0;
  }
  toString() {
    return this.items.join(",");
  }
}
十进制转二进制
js
function dec2bin(decNumber) {
  let stack = new Stack();
  let n = decNumber;
  while (n > 0) {
    stack.push(n % 2);
    n = Math.floor(n / 2);
  }
  let binaryString = "";
  while (!stack.isEmpty()) {
    binaryString = binaryString + stack.pop();
  }
  return binaryString;
}
队列
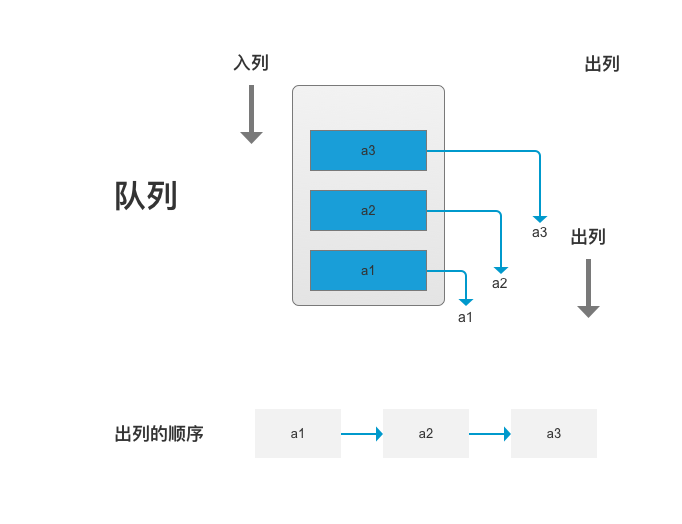
功能说明:队列是一种受限的数据结构,遵循先进先出(FIFO)原则,从两端进行操作,一端进队,一端出队。
核心概念:队列的变体与应用
队列的「先进先出」适合顺序处理/排队场景:消息队列、任务调度、BFS 广度遍历、缓冲区。常见变体有:优先级队列(按权重出队,如约瑟夫环)、双端队列 Deque(两端均可增删)、循环队列(复用数组空间)。
- 特点:队列是从两端进行操作,一边进一边出,先进的先出,在加入队列的时候可以设置优先级,优先级越高位置越前
普通队列
js
class Queue {
  constructor() {
    this.items = [];
  }
  // 入列
  enqueue(element) {
    this.items.push(element);
  }
  // 出列
  dequeue() {
    return this.items.shift();
  }
  // 查看队列顶元素
  front() {
    return this.items[0];
  }
  // 获取队列中元素的个数
  size() {
    return this.items.length;
  }
  // 判断队列中的元素是否为空
  isEmpty() {
    return this.items.length === 0;
  }
  toString() {
    return this.items.join(",");
  }
}
优先级队列
js
class PriorityQueue {
  constructor() {
    this.items = [];
  }
  // 入列
  enqueue(element, priority) {
    let enqueueItem = { element, priority };
    if (this.isEmpty()) {
      this.items.push(enqueueItem);
    } else {
      let hasAdd = false;
      for (let index = 0; index < this.items.length; index++) {
        // 数组越小优先级越高
        if (priority < this.items[index].priority) {
          this.items.splice(index, 0, enqueueItem);
          hasAdd = true;
          break;
        }
      }
      // 遍历结束还未插入
      if (!hasAdd) {
        this.items.push(enqueueItem);
      }
    }
  }
  // 出列
  dequeue() {
    return this.items.shift();
  }
  // 查看队列顶元素
  front() {
    return this.items[0];
  }
  // 获取队列中元素的个数
  size() {
    return this.items.length;
  }
  // 判断队列中的元素是否为空
  isEmpty() {
    return this.items.length === 0;
  }
  toString() {
    return JSON.stringify(this.items);
  }
}
js
// 有n个人,从1到y开始数数,每次数到y的人被淘汰,请问最后一个人谁,在原来的什么位置
function game(nameList, num) {
  let queue = new Queue();
  nameList.forEach((name) => {
    queue.enqueue(name);
  });
  while (queue.size() > 1) {
    for (var i = 1; i < num; i++) {
      queue.enqueue(queue.dequeue());
    }
    console.log(queue.dequeue());
  }
  let index = nameList.indexOf(queue.toString());
  console.log(`最终留下来的人${queue.toString()},原来${index}的位置`);
}
let nameList = ["lisi", "wangwu", "xianming", "tom"];
game(nameList, 3);
链表
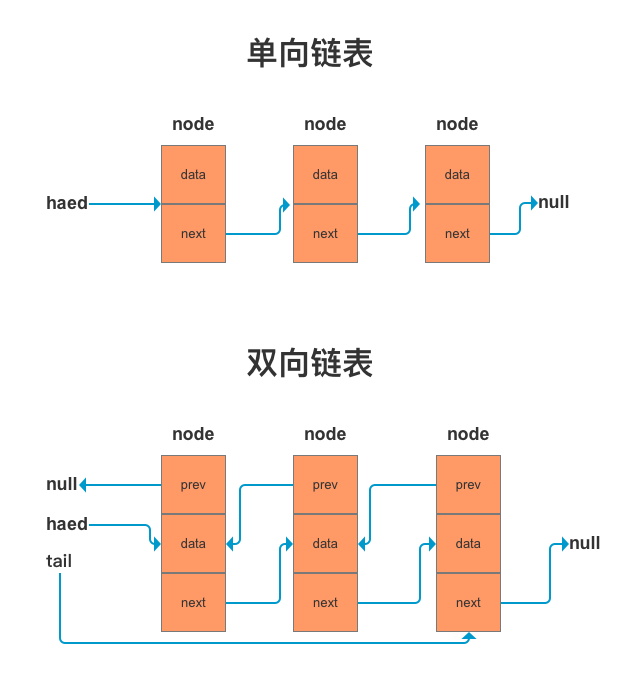
功能说明:链表是一种线性数据结构,通过指针连接节点,内存空间不连续,支持动态扩展。
核心概念:链表 vs 数组
链表用「指针指向」代替「连续内存」:每个节点保存数据和指向下一节点的引用。因此插入/删除只需改动指针(O(1)),无需位移;代价是不能随机访问,查找必须从头遍历(O(n))。单向链表只能单向遍历,双向链表额外维护 prev 指针支持双向遍历。
特点:
- 内存空间不是连续的,可以动态的利用内存
- 在创建的时候不必确定大小,并且可以无限的延伸下去
- 插入和删除数据时间复杂度可以达到 O(1)
缺点:
- 无法直接通过索引直接找到对应的元素,需要遍历
单向链表
js
class LinkedList {
  constructor() {
    this.head = null;
    this.length = 0;
  }

  // 链表元素
  node(element) {
    return {
      element: element,
      next: null,
    };
  }

  // 链表尾部添加数组
  append(element) {
    let newNode = this.node(element);
    // 如果没有数据
    if (this.head == null) {
      this.head = newNode;
    } else {
      // 遍历找到最后一个元素
      let currentNode = this.head;
      while (currentNode.next) {
        currentNode = currentNode.next;
      }
      // 追加元素
      currentNode.next = newNode;
    }
    this.length++;
  }

  // 指定的位置插入数据
  insert(position, element) {
    // 越界判断
    if (position < 0 || position > this.length)
      throw Error("LinkedListInsertBoundsException");
    let newNode = this.node(element);
    let currentNode = this.head;
    let prevNode = null;
    let index = 0;
    // 如果是第一个
    if (position === 0) {
      newNode.next = currentNode;
      this.head = newNode;
    } else {
      // 循环找到当前的要插入的位置
      while (index < position) {
        prevNode = currentNode;
        currentNode = currentNode.next;
        index++;
      }
      // 改变指针指向
      newNode.next = currentNode;
      prevNode.next = newNode;
    }
    this.length++;
    return true;
  }

  // 根据指定的位置删除元素
  removeAt(position) {
    // 越界判断
    if (position < 0 || position >= this.length)
      throw Error("LinkedListInsertBoundsException");
    let currentNode = this.head;
    let prevNode = null;
    let index = 0;
    // 如果是第一个
    if (position === 0) {
      this.head = currentNode.next;
    } else {
      // 循环找到当前的要删除的位置
      while (index < position) {
        prevNode = currentNode;
        currentNode = currentNode.next;
        index++;
      }
      // 改变指针指向
      prevNode.next = currentNode.next;
    }
    this.length--;
    return currentNode.element;
  }

  // 根据元素去查找元素指定的位置
  indexOf(element) {
    let currentNode = this.head;
    let index = 0;
    while (currentNode) {
      if (currentNode.element === element) {
        return index;
      }
      currentNode = currentNode.next;
      index++;
    }
    return -1;
  }

  // 根据元素删除元素
  remove(element) {
    let position = this.indexOf(element);
    return this.removeAt(position);
  }

  toString() {
    let currentNode = this.head;
    let nodeStr = "";
    while (currentNode) {
      nodeStr += "|" + currentNode.element;
      currentNode = currentNode.next;
    }
    return nodeStr.slice(1);
  }

  isEmpty() {
    return this.length === 0;
  }

  size() {
    return this.length;
  }

  // 查询头部元素
  getFirst() {
    return this.head.element;
  }
}
反转链表
反转链表的核心:三指针滚动
反转的关键是用 preNode / currentNode / nextNode 三个指针,逐个把当前节点的 next 指向前一个节点。每次循环前必须先用 nextNode 暂存后续链表,否则改向后链表会「断裂」丢失。
text
反转前: 1 → 2 → 3 → null
反转后: null ← 1 ← 2 ← 3   (即 3 → 2 → 1 → null)
js
function reverseLinkedListIterative(head) {
  let preNode = null; // 上一个
  let currentNode = head; // 当前的
  while (currentNode) {
    let nextNode = currentNode.next; // 保留后续的链表,防止冲断
    currentNode.next = preNode; // 让下一个节点,指向上一个节点
    preNode = currentNode; // 让上一个节点指向当前的节点
    currentNode = nextNode; // 继续循环
  }
  return preNode;
}

console.log(reverseLinkedListIterative(linkedList.head));
双向链表
js
class DoubleLinkedList {
  constructor() {
    this.head = null;
    this.tail = null;
    this.length = 0;
  }

  // 链表元素
  node(element) {
    return {
      element: element,
      prev: null,
      next: null,
    };
  }

  // 二分查找
  binarySearch(position) {
    if (this.length / 2 > position) {
      return {
        type: "front",
        position: position,
      };
    } else {
      return {
        type: "back",
        position: this.length - position,
      };
    }
  }

  // 链表尾部添加数组
  append(element) {
    let newNode = this.node(element);
    // 如果没有数据
    if (this.head == null) {
      this.head = newNode;
      this.tail = newNode;
    } else {
      // 遍历找到最后一个元素
      let currentNode = this.head;
      while (currentNode.next) {
        currentNode = currentNode.next;
      }
      // 追加元素
      newNode.prev = currentNode;
      currentNode.next = newNode;
      this.tail = newNode;
    }
    this.length++;
  }

  // 指定的位置插入数据
  insert(position, element) {
    // 越界判断
    if (position < 0 || position > this.length)
      throw Error("LinkedListInsertBoundsException");
    let newNode = this.node(element);
    // 如果是第一个
    if (position === 0) {
      // 数据为空
      if (this.head == null) {
        this.head = newNode;
        this.tail = newNode;
      } else {
        this.head.prev = newNode;
        newNode.next = this.head;
        this.head = newNode;
      }
    } else if (position === this.length) {
      // 如果是最后一个
      this.tail.next = newNode;
      newNode.prev = this.tail;
      this.tail = newNode;
    } else {
      let previous = null;
      let currentNode = null;
      let binarySearch = this.binarySearch(position);
      let index = 0;
      // 正向
      if (binarySearch.type === "front") {
        currentNode = this.head;
        // 循环找到当前的要插入的位置
        while (index < position) {
          previous = currentNode;
          currentNode = currentNode.next;
          index++;
        }
        // 交换节点的指向顺序
        newNode.next = currentNode;
        newNode.prev = previous;
        currentNode.prev = newNode;
        previous.next = newNode;
      } else {
        // 反向
        currentNode = this.tail;
        while (index < binarySearch.position) {
          previous = currentNode;
          currentNode = currentNode.prev;
          index++;
        }
        // 交换节点的指向顺序
        newNode.next = previous;
        newNode.prev = currentNode;
        currentNode.next = newNode;
        previous.prev = newNode;
      }
    }
    this.length++;
    return true;
  }

  // 根据指定的位置删除元素
  removeAt(position) {
    // 越界判断
    if (position < 0 || position >= this.length)
      throw Error("LinkedListInsertBoundsException");
    let currentNode = this.head;
    // 如果是第一个
    if (position === 0) {
      // 只有一个数组
      if (this.length === 1) {
        this.head = null;
        this.tail = null;
      } else {
        this.head = this.head.next;
        this.head.prev = null;
      }
    } else if (position === this.length - 1) {
      // 如果最后一个
      currentNode = this.tail;
      this.tail = this.tail.prev;
      this.tail.next = null;
    } else {
      let previous = null;
      let binarySearch = this.binarySearch(position);
      let index = 0;
      if (binarySearch.type === "front") {
        // 正向
        while (index < position) {
          previous = currentNode;
          currentNode = currentNode.next;
          index++;
        }
        previous.next = currentNode.next;
        currentNode.next.prev = previous;
        this.length--;
        return currentNode.element;
      } else {
        currentNode = this.tail;
        // 反向
        while (index < binarySearch.position) {
          previous = currentNode;
          currentNode = currentNode.prev;
          index++;
        }
        currentNode.next = previous.next;
        previous.next.prev = currentNode;
        this.length--;
        return previous.element;
      }
    }
  }

  // 根据元素去查找元素指定的位置
  indexOf(element) {
    let currentNode = this.head;
    let index = 0;
    while (currentNode) {
      if (currentNode.element === element) {
        return index;
      }
      currentNode = currentNode.next;
      index++;
    }
    return -1;
  }

  // 根据元素删除元素
  remove(element) {
    let position = this.indexOf(element);
    return this.removeAt(position);
  }

  isEmpty() {
    return this.length === 0;
  }

  size() {
    return this.length;
  }

  // 查询头部元素
  getHead() {
    return this.head.element;
  }

  // 查询尾部元素
  getTail() {
    return this.tail.element;
  }

  // 正向遍历
  forwardString() {
    let currentNode = this.head;
    let nodeStr = "";
    while (currentNode) {
      nodeStr += "|" + currentNode.element;
      currentNode = currentNode.next;
    }
    return nodeStr.slice(1);
  }

  // 反向遍历
  reverseString() {
    let currentNode = this.tail;
    let nodeStr = "";
    while (currentNode) {
      nodeStr += "|" + currentNode.element;
      currentNode = currentNode.prev;
    }
    return nodeStr.slice(1);
  }

  toString() {
    return this.forwardString();
  }
}
集合
功能说明:集合是一种数据结构,用于存储不重复的元素,无序且元素唯一。
核心概念:集合的本质
集合的核心特性是元素唯一 + 无序,底层常用对象或哈希表实现,因此判断元素是否存在(has)接近 O(1)。适合去重、成员判定,以及并集/交集/差集等集合运算。ES6 原生 Set 即是其实现。
- 特点:集合和数组类似,可以存储多个数据,它是无序的,并且不能重复(后添加的会覆盖前面的)
js
class Set {
  constructor() {
    this.items = {};
  }

  // 判断集合中是否有某个元素
  has(value) {
    return this.items.hasOwnProperty(value);
  }

  // 向集合中添加元素
  add(value) {
    this.items[value] = value;
    return true;
  }

  // 从集合中删除某个元素
  remove(value) {
    if (this.has(value)) {
      delete this.items[value];
      return true;
    }
    return false;
  }

  // 清空集合中所有的元素
  clear() {
    this.items = {};
  }

  // 获取集合的大小
  size() {
    return Object.keys(this.items).length;
  }

  // 获取集合中所有的值
  values() {
    return Object.keys(this.items);
  }
}
字典
功能说明:字典是一种键值对数据结构,用于存储不重复的键值对,无序且键唯一。
核心概念:字典 vs 集合
字典(Map)以 key-value 形式存储,key 唯一;而集合只存 value。可以把集合看作「只有 key 的字典」。字典适合需要通过标识快速取值的场景,ES6 原生 Map 即其实现,相比普通对象支持任意类型 key 且保持插入顺序。
- 特点:字典可以存储多个数据,它是无序的,并且不能重复(后添加的会覆盖前面的),以 key-value 形式存储
js
class Dictionary {
  constructor() {
    this.items = {};
  }

  // 判断字典中是否包含某个key
  has(key) {
    return this.items.hasOwnProperty(key);
  }

  // 在字典中添加键值对
  set(key, value) {
    this.items[key] = value;
    return true;
  }

  // 根据key去获取value
  get(key) {
    return this.has(key) ? this.items[key] : undefined;
  }

  // 从字典中移除元素
  remove(key) {
    if (this.has(key)) {
      delete this.items[key];
      return true;
    }
    return false;
  }

  // 获取所有的keys
  keys() {
    return Object.keys(this.items);
  }

  // 获取所有的value
  values() {
    return Object.values(this.items);
  }

  // size方法
  size() {
    return this.keys().length;
  }

  // clear方法
  clear() {
    this.items = {};
  }
}
哈希表
功能说明:哈希表是一种通过哈希函数将键映射到值的数据结构,提供快速的查找、插入和删除操作。
核心概念:哈希表为什么快?
哈希表通过哈希函数把 key 转换成数组索引,从而实现近似 O(1) 的存取——直接算出位置,而非逐个比较。理想的哈希函数应尽量均匀分布、减少碰撞。本文用霍纳算法计算 hashCode,用质数取模让分布更均匀。
哈希冲突与扩容
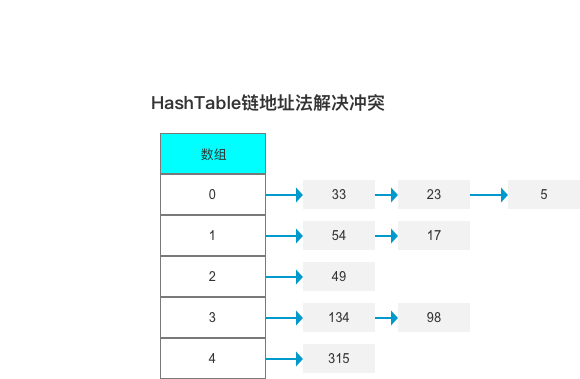
不同 key 算出相同索引即「哈希冲突」,常见解决方案:
- 链地址法(本文实现):每个槽位存一个数组/链表,冲突元素挂在同一槽位下。
- 开放寻址法:冲突时按规则探测下一个空槽位。
当装填因子(count/limit)过大时需 resize 扩容(元素多时翻倍)或缩容(元素少时减半)并重新散列,以维持性能。
- 特点:增加和删除操作效率高,可以达到瞬间查找
- 缺点:无法直接进行遍历,元素不能重复
- 实现原理:利用数组实现,当在存值的时候,首先把 key 作为条件,生成一个 hashCode 码,hashCode 码作为数组的索引,插入到二维数组中(链地址法解决冲突)
js
class HashTable {
  constructor() {
    this.storage = [];
    this.count = 0;
    this.limit = 8;
  }

  // 哈希函数
  hashFunc(str, max) {
    let hashCode = 0;
    // 霍纳算法, 来计算hashCode的数值
    for (let index = 0; index < str.length; index++) {
      // 质树有利于平均分布
      hashCode = 37 * hashCode + str.charCodeAt(index);
    }
    //压缩到指定的索引范围
    return hashCode % max;
  }

  // 判断是否是质数
  isPrime(num) {
    let temp = parseInt(Math.sqrt(num));
    for (let index = 2; index <= temp; index++) {
      if (num % index === 0) {
        return false;
      }
      return true;
    }
  }

  getPrime(num) {
    if (!this.isPrime(num)) return this.getPrime(++num);
    return num;
  }

  put(key, value) {
    // 生成索引
    let index = this.hashFunc(key, this.limit);
    let bucket = this.storage[index];
    if (bucket === undefined) {
      bucket = [];
      this.storage[index] = bucket;
    }
    let override = false;
    for (let i = 0; i < bucket.length; i++) {
      let temp = bucket[i];
      // 判断是否存在
      if (temp[0] === key) {
        temp[1] = value;
        override = true;
      }
    }
    // 不存在直接追加
    if (!override) {
      bucket.push([key, value]);
      this.count++;
      // 总长度超过限制的75%,需要扩容
      if (this.count > this.limit * 0.75) {
        this.resize(this.getPrime(this.limit * 2));
      }
    }
  }

  get(key) {
    let index = this.hashFunc(key, this.limit);
    let bucket = this.storage[index];
    if (bucket === undefined) {
      return null;
    }
    for (let i = 0; i < bucket.length; i++) {
      const temp = bucket[i];
      if (temp[0] === key) {
        return temp[1];
      }
    }
    return null;
  }

  remove(key) {
    let index = this.hashFunc(key, this.limit);
    let bucket = this.storage[index];
    if (bucket == undefined) {
      return null;
    }
    for (let i = 0; i < bucket.length; i++) {
      const temp = bucket[i];
      if (temp[0] === key) {
        bucket.splice(i, 1);
        this.count--;
        // 总长度小于限制的25%,需要缩小数组的容量
        if (this.limit > 7 && this.count < this.limit * 0.25) {
          this.resize(this.getPrime(Math.floor(this.limit / 2)));
        }
        return temp[1];
      }
      return null;
    }
  }

  resize(newLimit) {
    let oldStorage = this.storage;
    // 属性重置
    this.storage = [];
    this.limit = newLimit;
    this.count = 0;
    for (let index = 0; index < oldStorage.length; index++) {
      let arr = oldStorage[index];
      if (arr !== undefined) {
        arr.forEach((bucket) => {
          this.put(bucket[0], bucket[1]);
        });
      }
    }
  }

  isEmpty() {
    return this.count == 0;
  }

  size() {
    return this.count;
  }
}
二叉树
功能说明:二叉树是一种树形数据结构,每个节点最多有两个子节点,分别称为左子节点和右子节点。
核心概念:二叉搜索树(BST)与遍历
二叉搜索树满足「左子树所有节点 < 根 < 右子树所有节点」,因此中序遍历结果天然有序,查找/插入/删除平均 O(log n)。三种深度优先遍历只是「访问根节点的时机」不同:
- 先序(前序):根 → 左 → 右
- 中序:左 → 根 → 右(BST 中序即升序)
- 后序:左 → 右 → 根
注意:BST 极端情况下退化为链表(O(n)),实际工程常用 AVL、红黑树等自平衡树。
树的定义
- 树(Tree): n(n≥0)个结点构成的有限集合。
- 当 n=0 时,称为空树;
- 对于任一棵非空树(n> 0),它具备以下性质:
- 树中有一个称为“根(Root)”的特殊结点,用 r 表示;
- 其余结点可分为 m(m>0)个互不相交的有限集 T1,T2,... ,Tm,其中每个集合本身又是一棵树,称为原来树的“子树(SubTree)”
- 注意:
- 子树之间不可以相交
- 除了根结点外,每个结点有且仅有一个父结点;
树的术语
- 1.结点的度(Degree):结点的子树个数。
- 2.树的度:树的所有结点中最大的度数。(树的度通常为结点的个数 N-1)
- 3.叶结点(Leaf):度为 0 的结点。(也称为叶子结点)
- 4.父结点(Parent):有子树的结点是其子树的根结点的父结点
- 5.子结点(Child):若 A 结点是 B 结点的父结点,则称 B 结点是 A 结点的子结点;子结点也称孩子结点。
- 6.兄弟结点(Sibling):具有同一父结点的各结点彼此是兄弟结点。
- 7.路径和路径长度:从结点 n1 到 nk 的路径为一个结点序列 n1 , n2,… , nk, ni 是 ni+1 的父结点。路径所包含边的个数为路径的长度。
- 8.结点的层次(Level):规定根结点在 1 层,其它任一结点的层数是其父结点的层数加 1。
- 9.树的深度(Depth):树中所有结点中的最大层次是这棵树的深度。
二叉树的特性
- 1. 层结点数:一个二叉树第 i 层的最大结点数为:2^(i-1), i >= 1;
- 2. 总结点数:深度为 k 的二叉树有最大结点总数为: 2^k - 1, k >= 1;
- 3. 叶结点与度为 2 的结点关系:对任何非空二叉树 T,若 n0 表示叶结点的个数、n2 是度为 2 的非叶结点个数,那么两者满足关系 n0 = n2 + 1。
特殊二叉树
完美二叉树(Perfect Binary Tree):也称为满二叉树(Full Binary Tree)
- 在二叉树中, 除了最下一层的叶结点外, 每层节点都有 2 个子结点, 就构成了满二叉树.
完全二叉树(Complete Binary Tree)
- 除二叉树最后一层外, 其他各层的节点数都达到最大个数.
- 且最后一层从左向右的叶结点连续存在, 只缺右侧若干节点.
- 完美二叉树是特殊的完全二叉树.
二叉搜索树的特点:
- 二叉搜索树的特点就是相对较小的值总是保存在左结点上, 相对较大的值总是保存在右结点上.
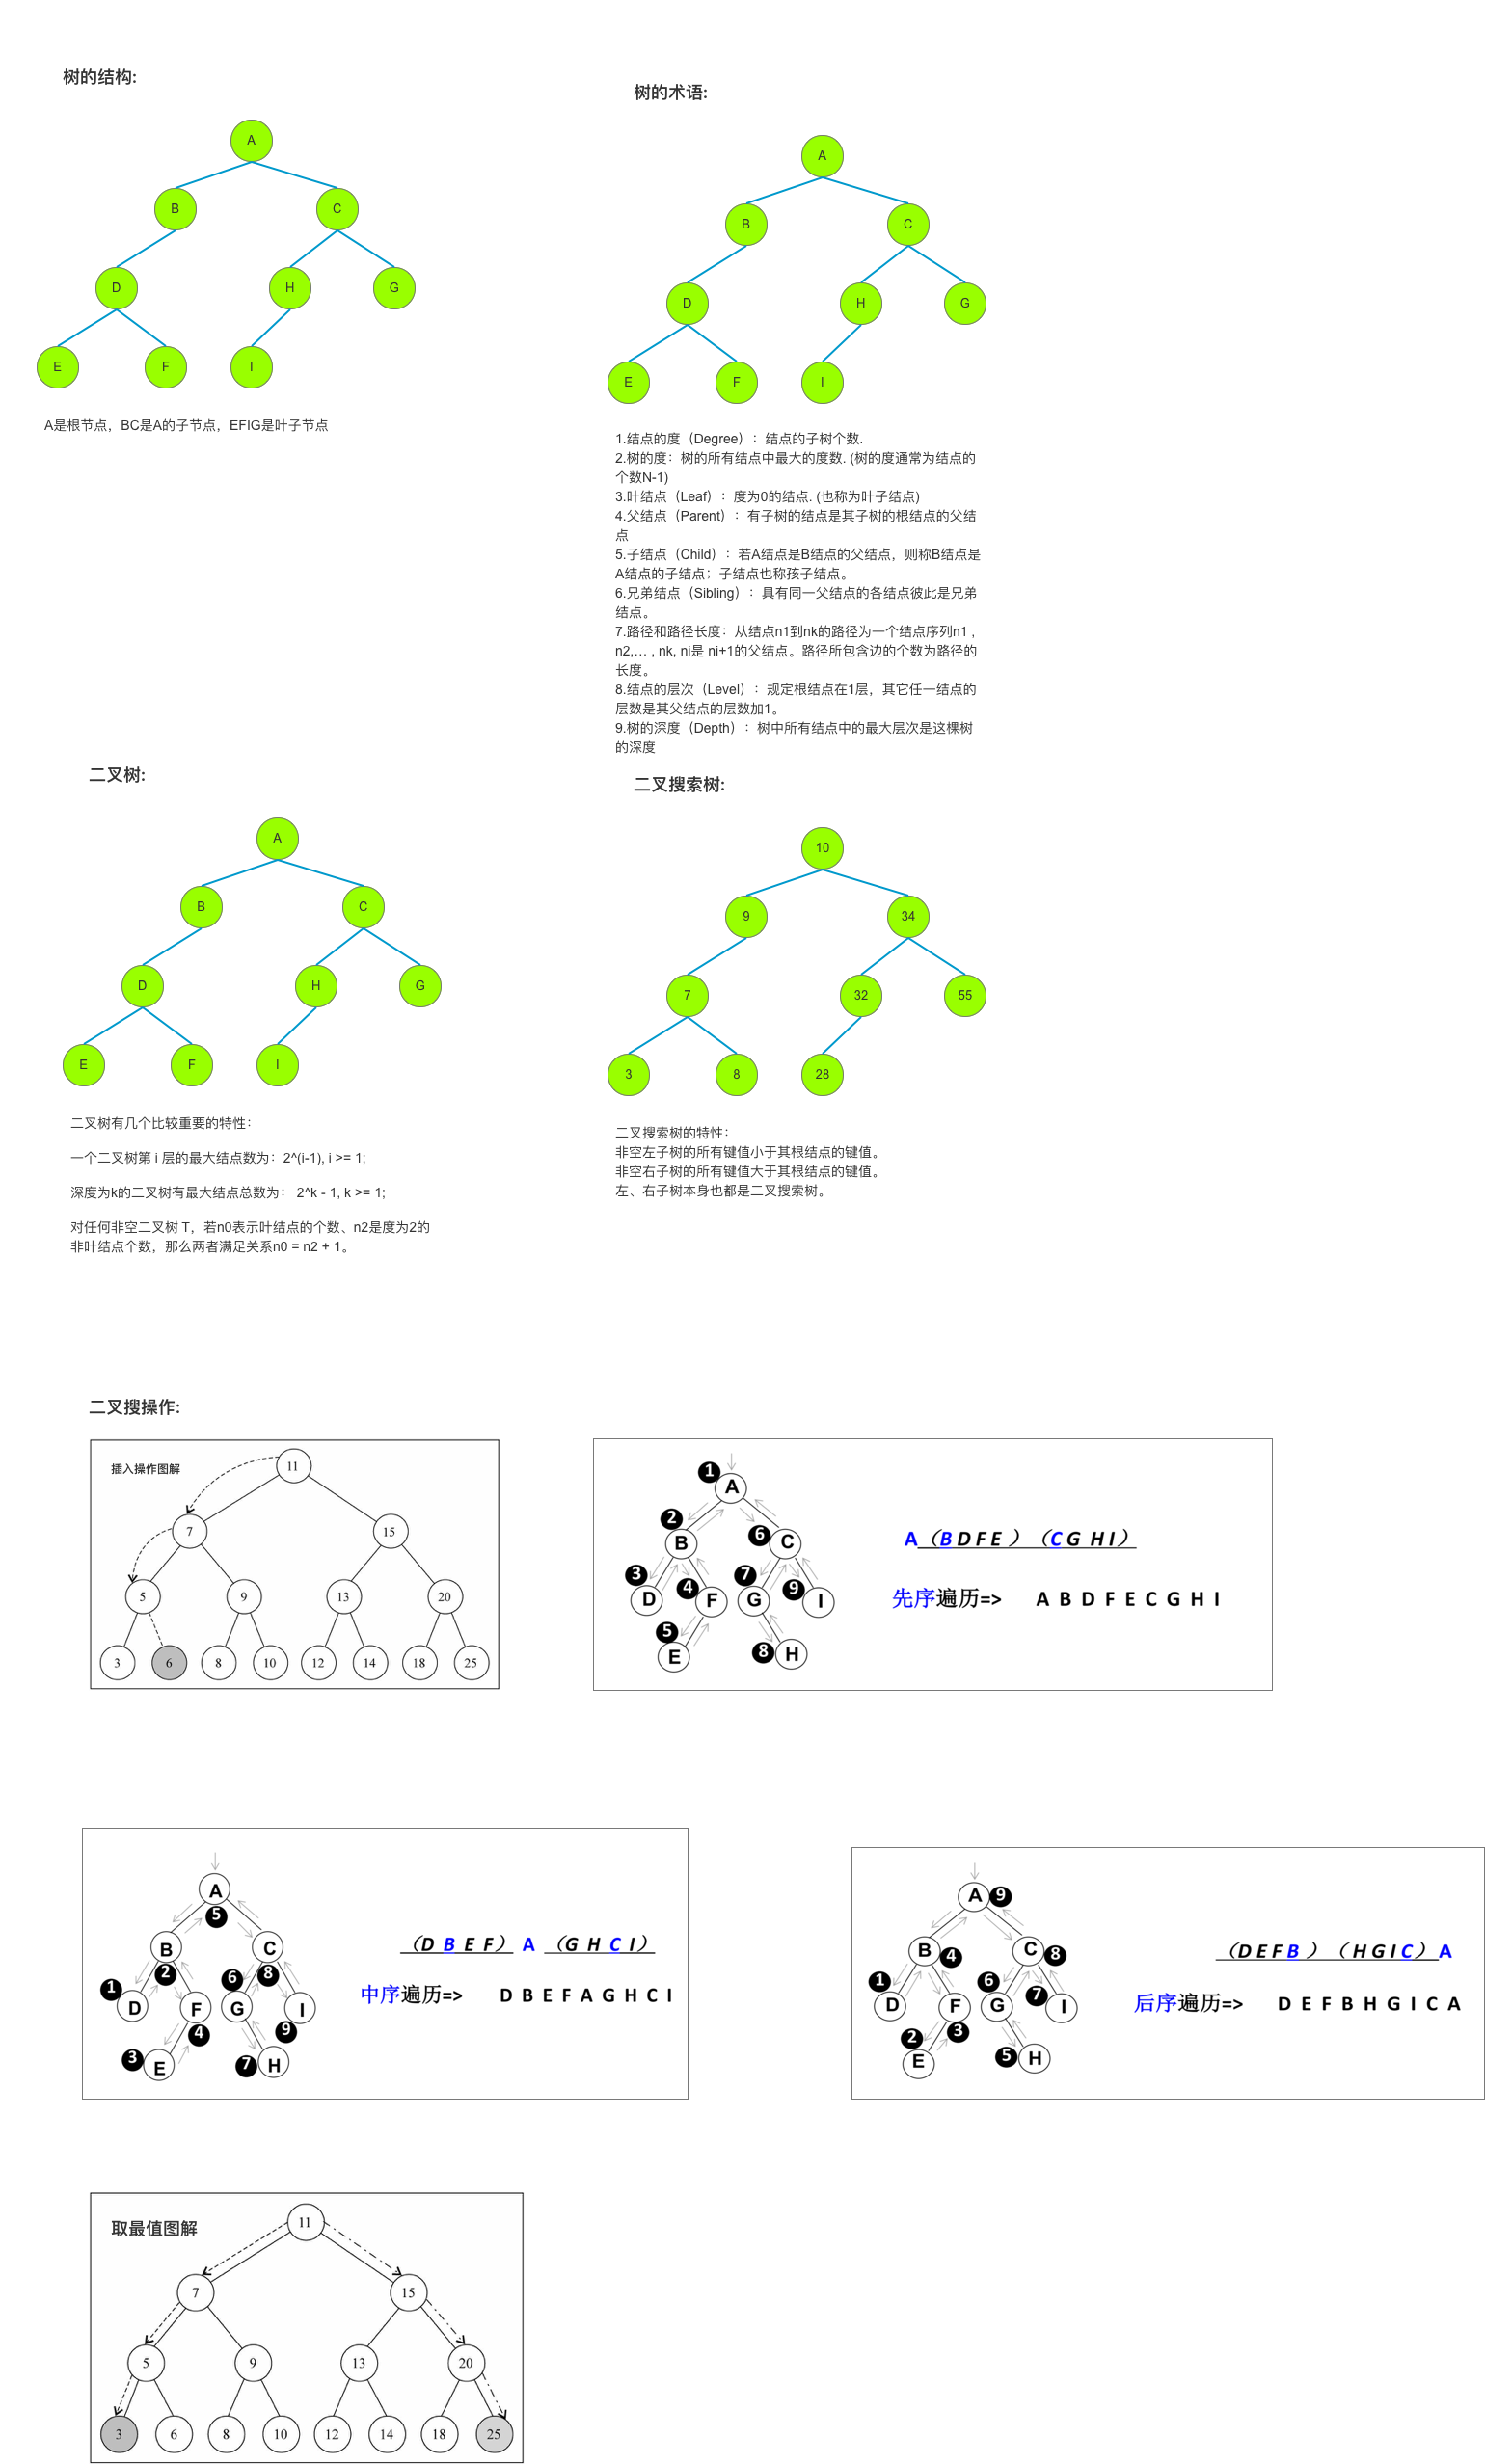
- 二叉搜索树的特点就是相对较小的值总是保存在左结点上, 相对较大的值总是保存在右结点上.
js
class BinarySearchTree {
  constructor() {
    this.root = null;
  }

  node(key) {
    return {
      key: key,
      left: null,
      right: null,
    };
  }

  // 插入操作
  insert(key) {
    let newNode = this.node(key);
    if (this.root === null) {
      this.root = newNode;
    } else {
      this.insertNode(this.root, newNode);
    }
  }

  insertNode(node, newNode) {
    // 小于向左找
    if (newNode.key < node.key) {
      // 如果没左节点
      if (node.left === null) {
        node.left = newNode;
      } else {
        // 如果有左节点,递归
        this.insertNode(node.left, newNode);
      }
    } else {
      if (node.right === null) {
        node.right = newNode;
      } else {
        this.insertNode(node.right, newNode);
      }
    }
  }

  /**
   * 深度优先遍历-先序遍历
   * ①访问根结点;
   * ②先序遍历其左子树;
   * ③先序遍历其右子树
   */

  preOrderTraverse(handler) {
    this.preOrderTraverseNode(this.root, handler);
  }

  preOrderTraverseNode(node, handler) {
    if (node !== null) {
      handler(node.key);
      this.preOrderTraverseNode(node.left, handler);
      this.preOrderTraverseNode(node.right, handler);
    }
  }

  /**
   * 深度优先遍历-中序遍历
   * ①中序遍历其左子树;
   * ②访问根结点;
   * ③中序遍历其右子树。
   */
  inOrderTraversal(handler) {
    this.inOrderTraversalNode(this.root, handler);
  }

  inOrderTraversalNode(node, handler) {
    if (node !== null) {
      this.inOrderTraversalNode(node.left, handler);
      handler(node.key);
      this.inOrderTraversalNode(node.right, handler);
    }
  }

  /**
   * 深度优先遍历-后序遍历
   * ①后序遍历其左子树;
   * ②后序遍历其右子树;
   * ③访问根结点。
   */
  postOrderTraversal(handler) {
    this.postOrderTraversalNode(this.root, handler);
  }

  postOrderTraversalNode(node, handler) {
    if (node !== null) {
      this.postOrderTraversalNode(node.left, handler);
      this.postOrderTraversalNode(node.right, handler);
      handler(node.key);
    }
  }

  // 删除节点
  remove(key) {
    let current = this.root;
    let parent = null;
    let isLeftChild = true;
    while (current.key != key) {
      parent = current;
      if (key > current.key) {
        isLeftChild = false;
        current = current.right;
      } else {
        isLeftChild = true;
        current = current.left;
      }
      // 如果current已经指向null, 那么说明没有找到要删除的数据
      if (current === null) return false;
    }

    // 情况一:如果是叶节点
    if (current.left === null && current.right === null) {
      // 正好的根节点
      if (current === this.root) {
        this.root = null;
      } else if (isLeftChild) {
        parent.left = null;
      } else {
        parent.right = null;
      }
    }
    // 情况二:只有一个节点
    else if (current.left === null) {
      // 如果是根节点
      if (current === this.root) {
        this.root = current.right;
      } else if (isLeftChild) {
        parent.left = current.right;
      } else {
        parent.right = current.right;
      }
    } else if (current.right === null) {
      // 如果是根节点
      if (current === this.root) {
        this.root = current.left;
      } else if (isLeftChild) {
        parent.left = current.left;
      } else {
        parent.right = current.left;
      }
    } else {
      /**
       * 删除有两个节点的节点(操作完成后还需要满足二叉搜索数的特性)
       * 方案一:把当前要删除的左子数最大的提取上去(前驱)
       * 方案二:把当前要删除的右子数最小的提取上去(后继)
       */
      let successor = this.getSuccessor(current);
      if (current === this.root) {
        this.root = successor;
      } else if (isLeftChild) {
        parent.left = successor;
      } else {
        parent.right = successor;
      }
      successor.left = current.left;
    }
    return true;
  }

  // 找后继的方法
  getSuccessor(delNode) {
    let successorParent = delNode;
    let successor = delNode;
    let current = delNode.right; // 要从右子树开始找

    while (current != null) {
      successorParent = successor;
      successor = current;
      current = current.left;
    }

    // 如果提取上去的节点有子节点
    if (successor != delNode.right) {
      successorParent.left = successor.right;
      successor.right = delNode.right;
    }

    return successor;
  }

  // 搜搜特定的值
  search(key) {
    let node = this.root;
    while (node !== null) {
      if (key < node.key) {
        node = node.left;
      } else if (key > node.key) {
        node = node.right;
      } else {
        return node;
      }
    }
    return null;
  }

  // 或取最小值
  min() {
    let node = this.root;
    while (node.left !== null) {
      node = node.left;
    }
    return node.key;
  }
  // 或取最大值
  max() {
    let node = this.root;
    while (node.right !== null) {
      node = node.right;
    }
    return node.key;
  }
}

// 测试代码
var bst = new BinarySearchTree();

// 插入数据
bst.insert(10);
bst.insert(9);
bst.insert(34);
bst.insert(7);
bst.insert(3);
bst.insert(8);
bst.insert(32);
bst.insert(55);
bst.insert(28);
let stra = "";
console.log(bst.remove(10));
bst.preOrderTraverse((key) => {
  stra = stra + " " + key;
});
console.log("先序", stra);

let strb = "";
bst.inOrderTraversal((key) => {
  strb = strb + " " + key;
});
console.log("中序", strb);
let strc = "";
bst.postOrderTraversal((key) => {
  strc = strc + " " + key;
});
console.log("后序", strc);
三种遍历顺序图解
以下二叉搜索树为例,观察三种遍历的访问次序(记住:先/中/后 指的是「根节点」被访问的时机):
text
        8
      /   \
     3     10
    / \      \
1 6 14- 先序:8 → 3 → 1 → 6 → 10 → 14(根 左 右)
- 中序:1 → 3 → 6 → 8 → 10 → 14(左 根 右,结果升序)
- 后序:1 → 6 → 3 → 14 → 10 → 8(左 右 根)
排序算法总览
核心概念:如何评价一个排序算法?
评价排序算法主要看三个维度:时间复杂度(比较/交换次数)、空间复杂度(是否原地排序)、稳定性(相等元素的相对次序是否保持不变)。工程中常按数据规模选择:小规模用插入排序,大规模用快排/归并。
| 排序算法 | 平均时间 | 最坏时间 | 空间 | 稳定性 | 特点 |
|---|---|---|---|---|---|
| 冒泡排序 | O(n²) | O(n²) | O(1) | 稳定 | 相邻比较交换,简单直观 |
| 选择排序 | O(n²) | O(n²) | O(1) | 不稳定 | 每轮选最小放前面,交换次数少 |
| 插入排序 | O(n²) | O(n²) | O(1) | 稳定 | 近乎有序时接近 O(n) |
| 希尔排序 | O(n^1.3) | O(n²) | O(1) | 不稳定 | 插入排序的分组增量优化 |
| 快速排序 | O(n log n) | O(n²) | O(log n) | 不稳定 | 分治+基准划分,实际最快 |
冒泡排序
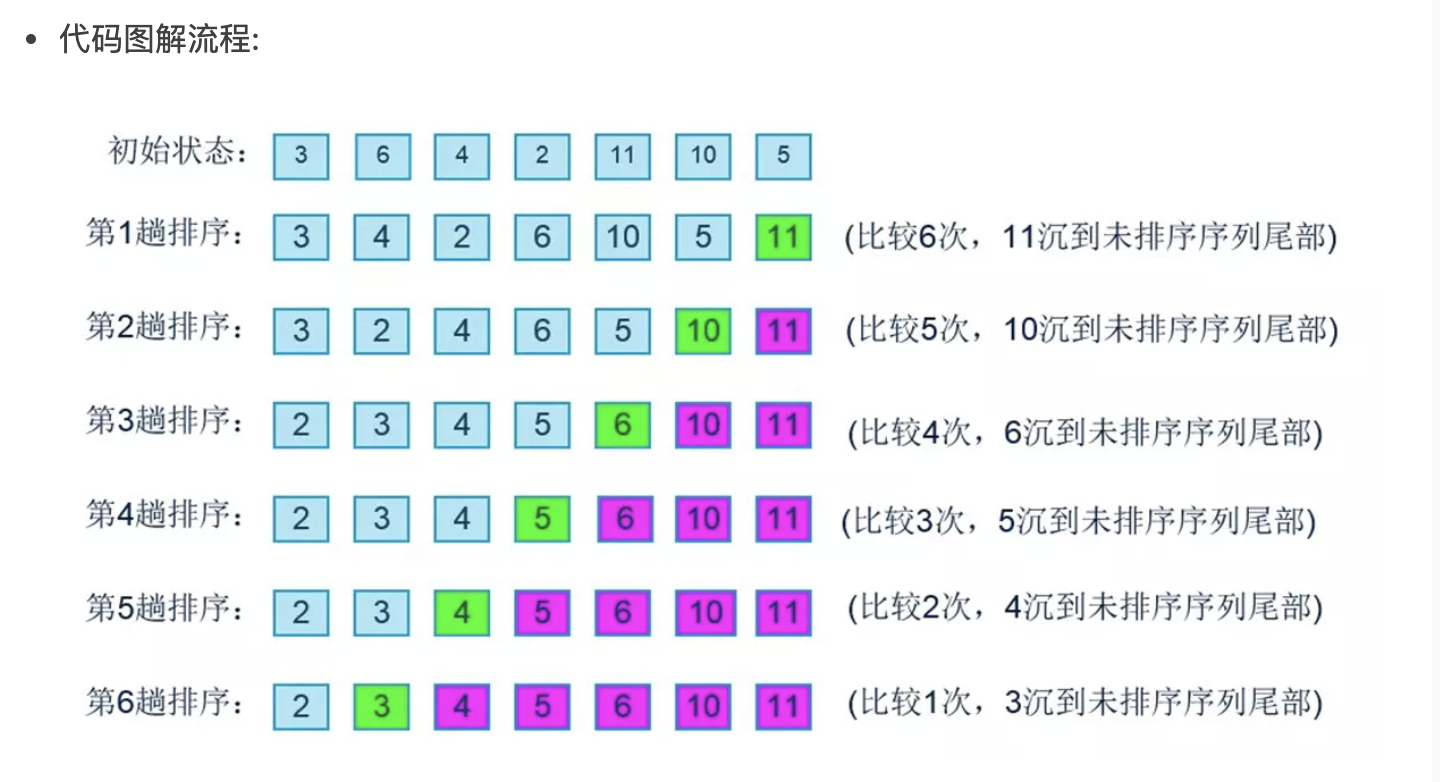
功能说明:冒泡排序是一种简单的排序算法,通过重复地比较相邻的两个元素并交换它们的位置,直到整个数组排序完成。
思路:
- 每相邻的二个元素进行比较如果大于就交换顺序
- 第一次找出最高的一位放置在末尾
- 第二次找出次高的一位放置在倒数第二,依次内推
代码实现:
- 外层循环控制每次对比的次数,对比的次数依次减少
- 内层循环两两进行对比,内外层循环结束顺序就依次排列好
时间复杂度:
- 对比的次数和交换的次数都是 O(N^2)
js
class ArrayList {
  constructor() {
    this.array = [];
  }
  insert(item) {
    this.array.push(item);
  }
  toString() {
    return this.array.join(",");
  }
  // 交换
  swap(x, y) {
    let temp = this.array[x];
    this.array[x] = this.array[y];
    this.array[y] = temp;
  }

  bubbleSort() {
    let len = this.array.length;
    for (let i = 0; i < len - 1; i++) {
      for (let j = i + 1; j < len; j++) {
        if (this.array[i] > this.array[j]) {
          this.swap(i, j);
        }
      }
    }
  }
}

let arrayList = new ArrayList();
arrayList.insert(3);
arrayList.insert(6);
arrayList.insert(4);
arrayList.insert(2);
arrayList.insert(11);
arrayList.insert(10);
arrayList.insert(5);
arrayList.bubbleSort();
console.log(arrayList.toString()); // 2,3,4,5,6,10,11
选择排序
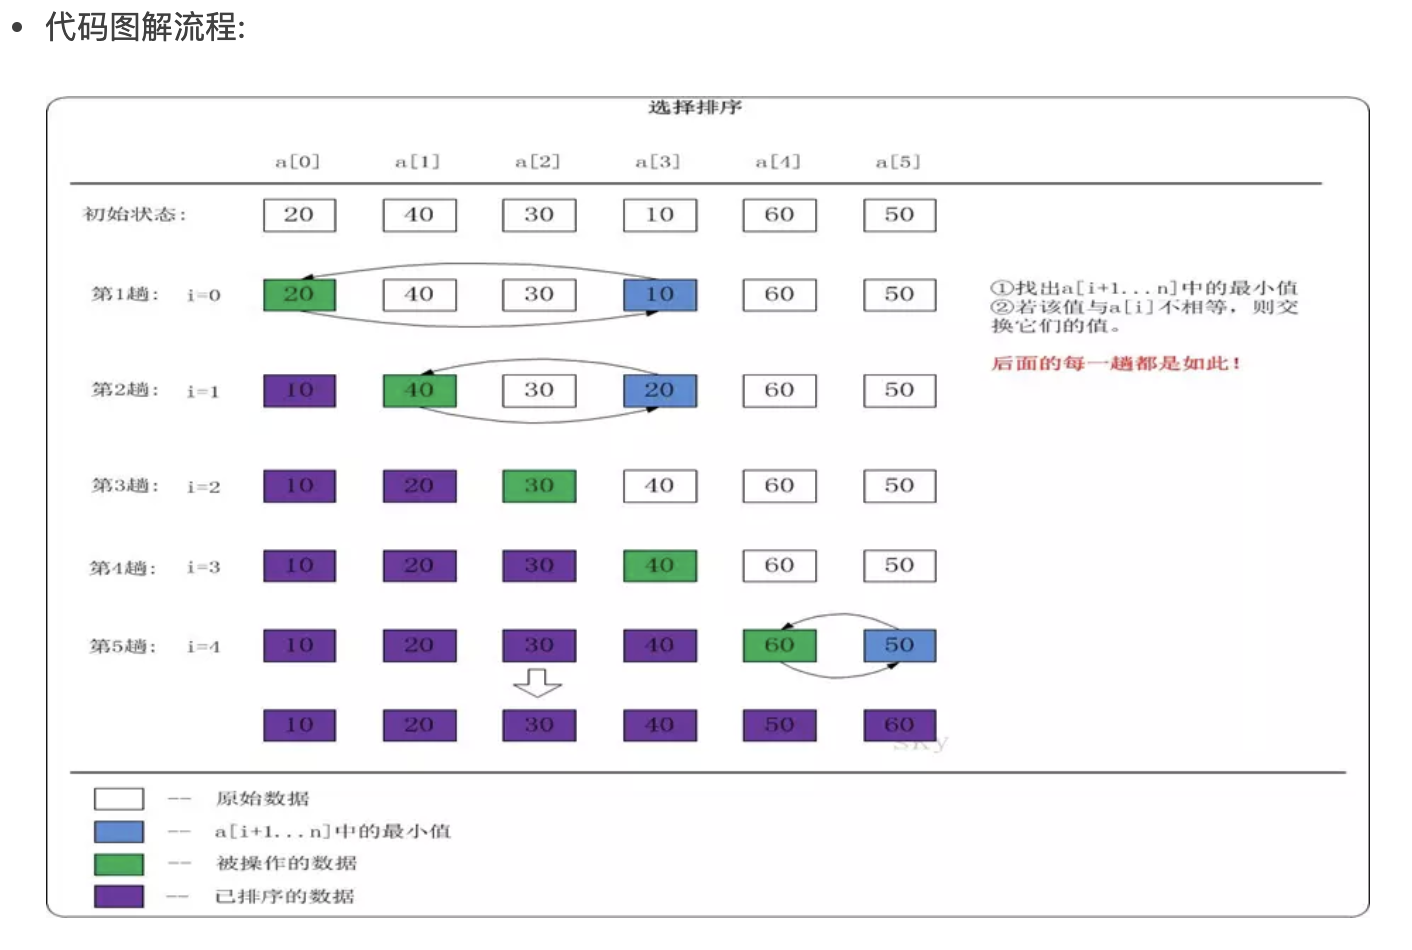
功能说明:选择排序是一种简单的排序算法,每次从未排序部分选择最小的元素,放到已排序部分的末尾。
思路:
- 选择第一个索引的位置,依次和后面的进行比较
- 如果大于就交换它们的位置,循环到最后,就能确定最小的位置的索引
- 用最小位置的索引的值和第一个索引进行交换,依次内推
代码实现:
- 外层循环记录需要交换的索引位置,每次交换后需要从下一个索引开始,所以依次递增
- 内层循环依次进行对比找出最小的值的索引,内层循环结束后交换值位置
时间复杂度:
- 对比的次数 O(N^2)
- 交换的次数都是 O(N)
js
class ArrayList {
  constructor() {
    this.array = [];
  }
  insert(item) {
    this.array.push(item);
  }
  toString() {
    return this.array.join(",");
  }
  // 交换
  swap(x, y) {
    let temp = this.array[x];
    this.array[x] = this.array[y];
    this.array[y] = temp;
  }

  selectionSort() {
    let len = this.array.length;
    for (let i = 0; i < len - 1; i++) {
      let min = i;
      // 内循环找出最小的值的索引
      for (let j = i + 1; j < len; j++) {
        if (this.array[min] > this.array[j]) {
          min = j;
        }
      }
      // 交换
      this.swap(i, min);
    }
  }
}

let arrayList = new ArrayList();
arrayList.insert(20);
arrayList.insert(40);
arrayList.insert(30);
arrayList.insert(10);
arrayList.insert(60);
arrayList.insert(50);
arrayList.selectionSort();
console.log(arrayList.toString()); // 10,20,30,40,50,60
插入排序
功能说明:插入排序是一种简单的排序算法,将数组分为已排序和未排序两部分,每次将未排序部分的第一个元素插入到已排序部分的正确位置。
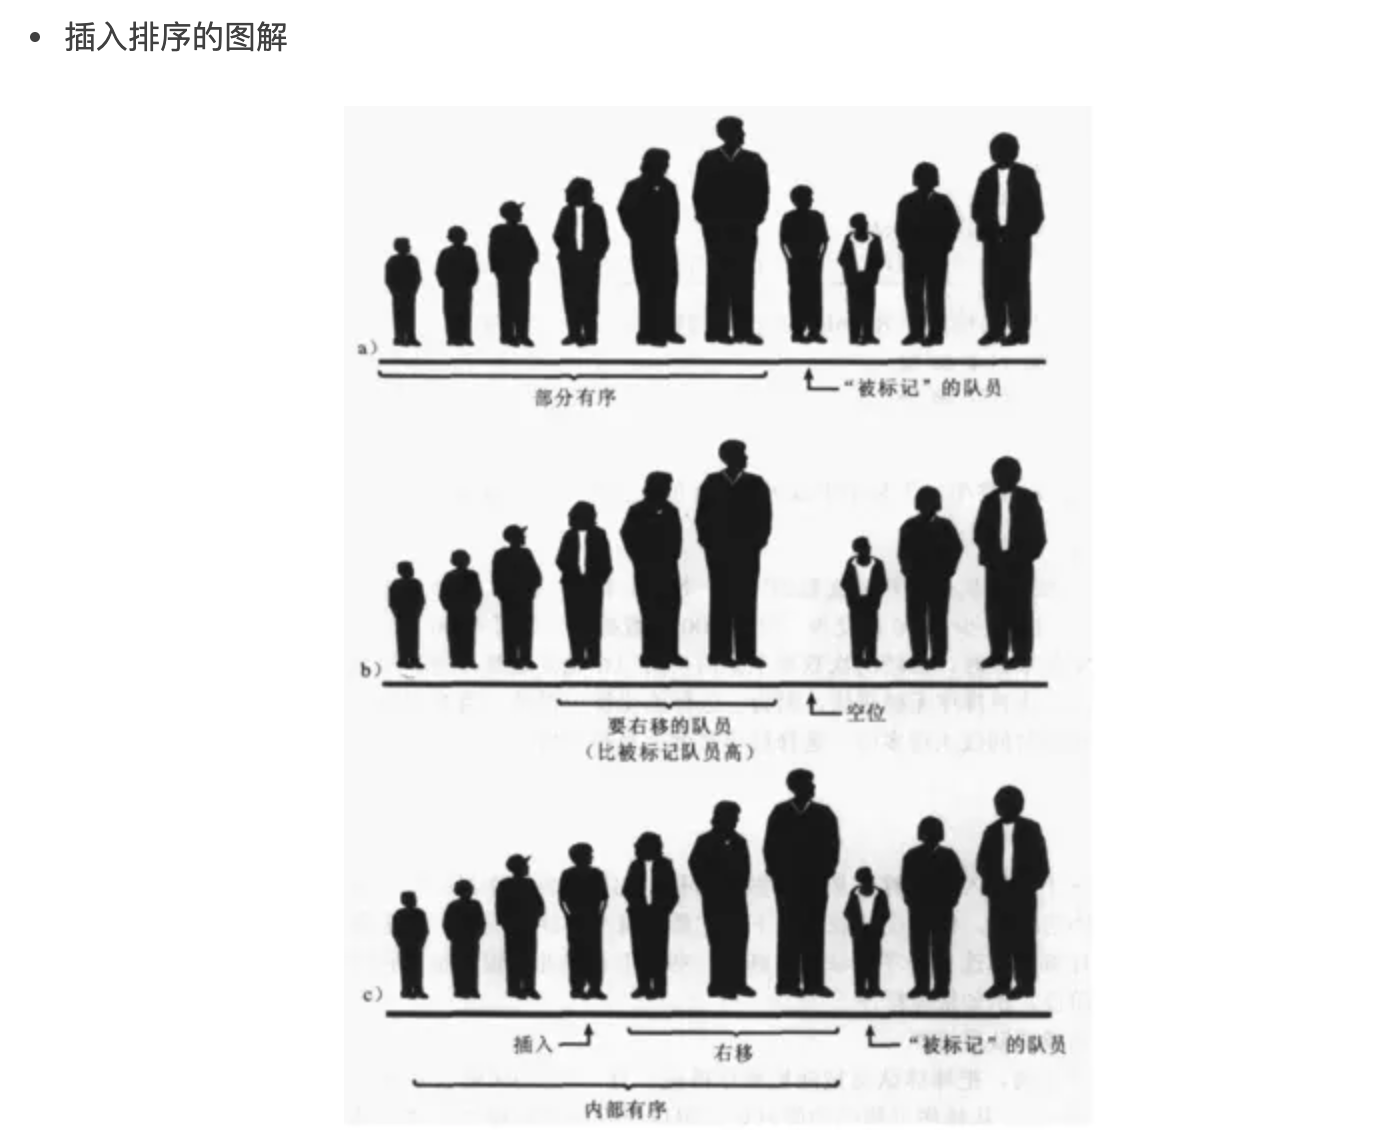
思路:
- 从下标一开始,默认 0 的位置可以看成局部有序
- 从第一个开始依次往前进行对比,大于就交换顺序,直到对比到第一个下标的位置
代码实现:
- 外层循环控制对比的次数,记录索引的位置和值,索引依次递增
- 内层循环进行对比,大于就直接赋值,并且记录索引的位置
- 内层循环结束后,录索引的位置进行赋值
时间复杂度:
- 对比的次数 O(N^2)
- 交换的次数都是 O(N)
js
class ArrayList {
  constructor() {
    this.array = [];
  }

  insert(item) {
    this.array.push(item);
  }

  toString() {
    return this.array.join(",");
  }

  // 交换
  swap(x, y) {
    let temp = this.array[x];
    this.array[x] = this.array[y];
    this.array[y] = temp;
  }

  insertionSort() {
    const len = this.array.length;
    for (let i = 1; i < len; i++) {
      let j = i;
      let temp = this.array[i];
      while (j > 0 && this.array[j - 1] > temp) {
        this.array[j] = this.array[j - 1];
        j--;
      }
      this.array[j] = temp;
    }
  }
}

let array = new ArrayList();
array.insert(10);
array.insert(1);
array.insert(20);
array.insert(4);
array.insertionSort();
console.log(array.toString());
希尔排序
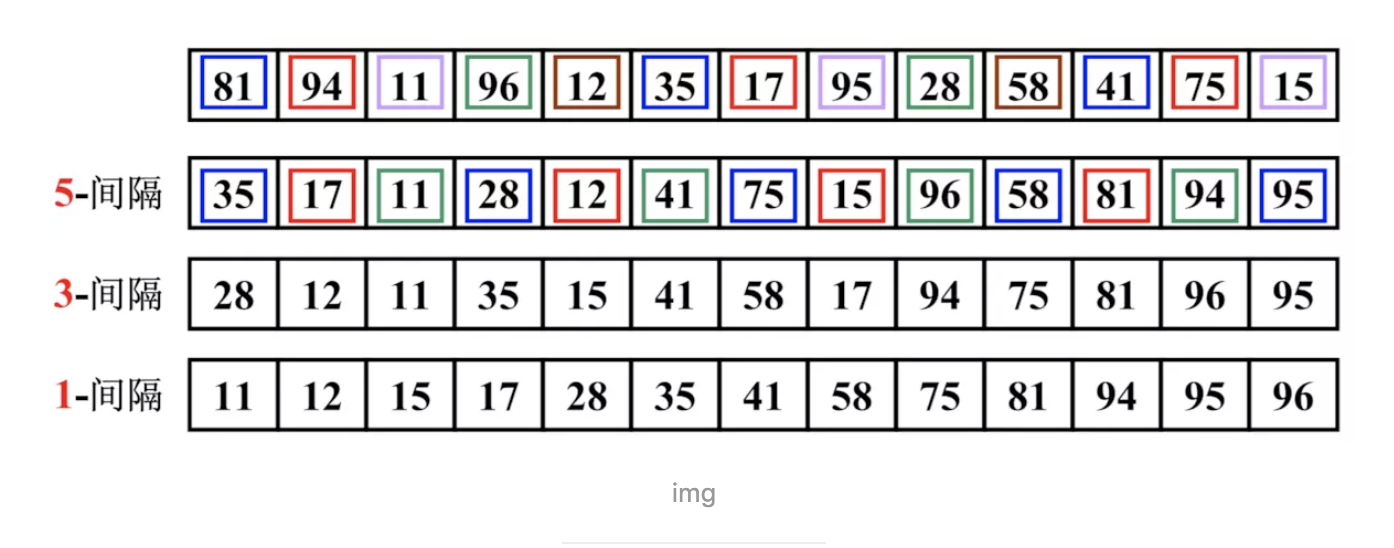
功能说明:希尔排序是插入排序的改进版,通过设置间隔(增量)对数据进行分组排序,逐步减小间隔直到为 1。
希尔排序为什么比插入排序快?
普通插入排序每次只能把元素移动一位,若小元素在末尾则要移动很多次。希尔排序先用较大增量分组,让元素大跨度跳跃到接近最终位置,随着增量减小逐步「精调」,最后增量为 1 时数组已近乎有序,插入排序开销大幅降低。增量序列的选取直接影响性能。
实现原理:
- 首先获取一个增量
- 外层循环增量不断变小, 大于 0 就继续改变增量
- 内层循环实现了插入排序
时间复杂度:
- 最坏的情况 O(N^2)
js
class ArrayList {
  constructor() {
    this.array = [];
  }

  insert(item) {
    this.array.push(item);
  }

  toString() {
    return this.array.join(",");
  }

  // 交换
  swap(x, y) {
    let temp = this.array[x];
    this.array[x] = this.array[y];
    this.array[y] = temp;
  }

  shellSort() {
    const len = this.array.length;
    let gap = Math.floor(len / 2);
    while (gap > 0) {
      for (let i = gap; i < this.array.length; i++) {
        let j = i;
        let temp = this.array[i];
        while (j > gap - 1 && this.array[j - gap] > temp) {
          this.array[j] = this.array[j - gap];
          j -= gap;
        }
        this.array[j] = temp;
      }
      gap = Math.floor(gap / 2);
    }
  }
}

let array = new ArrayList();
array.insert(10);
array.insert(1);
array.insert(20);
array.insert(4);
array.shellSort();
console.log(array.toString());
快速排序
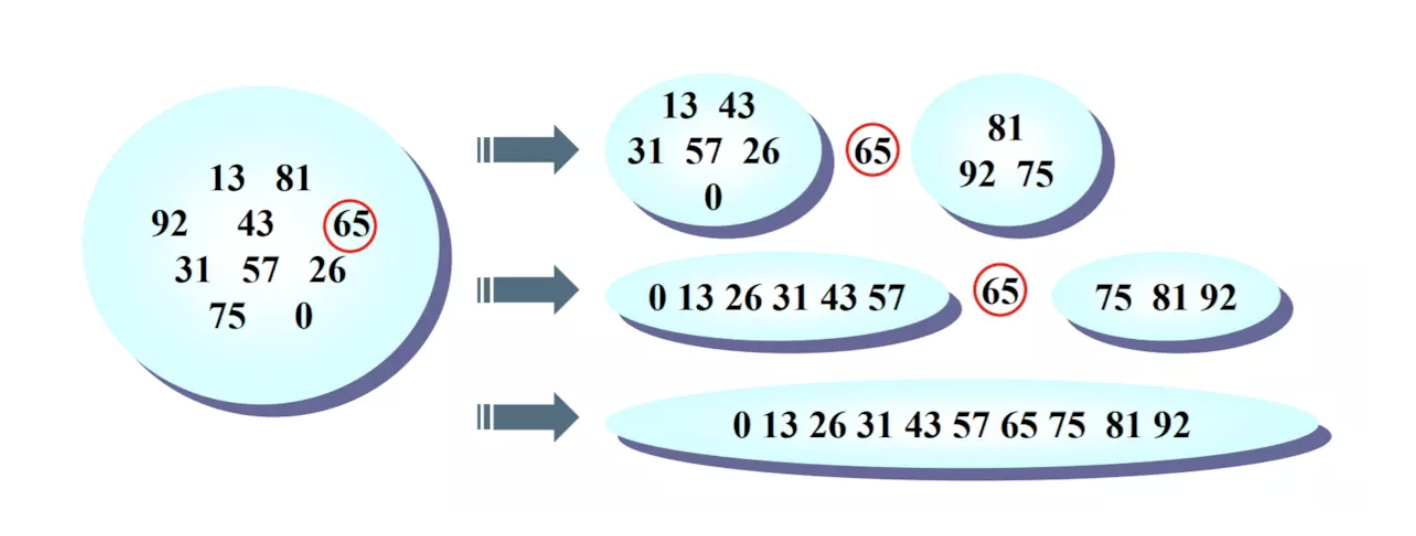
功能说明:快速排序是一种高效的排序算法,通过选择一个枢纽元素,将数组分为比枢纽小和比枢纽大的两部分,然后递归排序这两部分。
快排的关键:基准选择与最坏情况
快排本质是「分治」:选基准(pivot)→ 划分 → 递归左右两半。基准选得好坏直接决定性能:若每次都选到最大/最小值(如对已有序数组固定取第一个),划分极不均衡,退化为 O(n²)。工程上常用「三数取中」或随机基准来规避最坏情况。快排原地排序、常数因子小,是实际最常用的排序。
- 思路
- 选择第一位最为枢纽
- 从第二位开始进行遍历
- 比枢纽小的放在左边,大的放在右边,此时枢纽就是正确的位置
- 左边、右边也是一个数组,在进行递归,所有的递归结束后就排好顺序
- 时间复杂度
- O(N*logN)
js
class ArrayList {
  constructor() {
    this.array = [];
  }

  insert(item) {
    this.array.push(item);
  }

  toString() {
    return this.array.join(",");
  }

  quick(list) {
    if (!Array.isArray(list)) {
      return list;
    }

    if (list.length === 0) {
      return [];
    }
    let pivot = list[0];
    let mins = [];
    let maxs = [];
    for (let index = 1; index < list.length; index++) {
      let item = list[index];
      if (pivot > item) {
        mins.push(item);
      } else {
        maxs.push(item);
      }
    }

    return [...this.quick(mins), pivot, ...this.quick(maxs)];
  }

  quickSort() {
    this.array = this.quick(this.array);
  }
}

let array = new ArrayList();
array.insert(10);
array.insert(1);
array.insert(20);
array.insert(4);
array.quickSort();
console.log(array.toString());
二分查找
功能说明:二分查找是一种高效的查找算法,适用于已排序的数组,通过每次比较中间元素来缩小查找范围。
核心概念:为什么是 O(log n)?
二分查找每比较一次就排除掉一半的数据,n 个元素最多比较 log₂n 次即可定位,远快于线性查找的 O(n)。这也是「有序」带来的红利。
使用前提
二分查找必须作用于有序数组,无序数据要先排序(排序成本 O(n log n))。若只查一次,线性查找可能更划算;若反复查询,则「一次排序 + 多次二分」更优。此外中点计算 (low + high) / 2 在其他语言中需注意整型溢出,可写成 low + (high - low) / 2。
思路
- 每次取从中间的位置开始
- 如果找到返回索引
- 如果中间的数值大,继续从左找
- 如果中间的数值小,继续从右找
- 循环结束后还未找到返回-1
时间复杂度
- O(logN)
js
class ArrayList {
  constructor() {
    this.array = [];
  }

  insert(item) {
    this.array.push(item);
  }

  binarySearch(element) {
    let minIndex = 0;
    let maxIndex = this.array.length - 1;
    let middleValue;
    while (minIndex <= maxIndex) {
      // 中间开始查找
      let middleIndex = parseInt((minIndex + maxIndex) / 2);
      middleValue = this.array[middleIndex];
      if (middleValue === element) {
        return middleIndex;
      } else if (middleValue > element) {
        // 左找
        // 中间位置的前一个开始
        maxIndex = middleIndex - 1;
      } else {
        // 中间位置的后一个开始
        minIndex = middleIndex + 1; // 右找
      }
    }
    return -1;
  }
}

let array = new ArrayList();
array.insert(1);
array.insert(2);
array.insert(3);
array.insert(4);
array.insert(5);
array.insert(19);
console.log(array.binarySearch(119));
深度优先搜索(DFS)
功能说明:深度优先搜索是一种用于遍历或搜索树或图的算法,它尽可能深地探索树的分支,直到不能再深入为止,然后回溯。
核心概念:DFS 的实现方式
DFS「一条路走到黑,走不通再回溯」,天然契合栈结构:递归实现借助的是系统调用栈,也可用显式栈改写为迭代。前端中 React 的虚拟 DOM 构建、Fiber 树遍历都用到 DFS 思想。
- 定义:深度优先搜索英文缩写为 DFS 即 Depth First Search
- 过程:对每一个可能的分支路径深入到不能再深入为止,而且每个节点只能访问一次
- 应用场景
- React 虚拟 DOM 的构建
- React 的 fiber 树构建
实现思路
- 先访问根节点,如果有 children,遍历 children 节点,递归 dfs
js
// 对象的情况
function dfs(node) {
  console.log(node.name);
  node.children &&
    node.children.forEach((child) => {
      dfs(child);
    });
}
let root = {
  name: "A",
  children: [
    {
      name: "B",
      children: [{ name: "B1" }, { name: "B2" }],
    },
    {
      name: "C",
      children: [{ name: "C1" }, { name: "C2" }],
    },
  ],
};
dfs(root); // A B B1 B2 C C1 C2
js
// 数组的情况
function dfs(root) {
  root &&
    root.forEach((node) => {
      console.log(node.name);
      dfs(node.children);
    });
}
let root = [
  {
    name: "A",
    children: [
      {
        name: "B",
        children: [{ name: "B1" }, { name: "B2" }],
      },
      {
        name: "C",
        children: [{ name: "C1" }, { name: "C2" }],
      },
    ],
  },
  {
    name: "A1",
    children: [
      {
        name: "B1",
        children: [{ name: "B11" }, { name: "B21" }],
      },
      {
        name: "C1",
        children: [{ name: "C11" }, { name: "C21" }],
      },
    ],
  },
];
dfs(root);
广度优先搜索(BFS)
功能说明:广度优先搜索是一种用于遍历或搜索树或图的算法,它从根节点开始,先访问所有相邻节点,然后再访问这些节点的相邻节点,以此类推。
核心概念:BFS 借助队列「逐层扩散」
BFS「一层一层向外扩散」,天然契合队列结构(FIFO):取出队头节点、访问它、把它的子节点全部入队,循环直到队空。因为按距离由近及远访问,BFS 常用于求无权图的最短路径。
- 定义:宽度优先搜索算法(又称广度优先搜索),其英文全称是 Breadth First Search
- 过程:算法首先搜索距离为 k 的所有顶点,然后再去搜索距离为 k+1 的其他顶点
实现思路(利用队列的特性)
- 1、首先创建一个数组,将根节点添加到数组中
- 2、进入 while 循环,每次取队列头部的节点,如果节点中有 children,遍历 children 节点,添加到数组中
js
// 对象的情况
function bfs(node) {
  const stack = [];
  stack.push(node);
  let current = stack.shift();
  while (current) {
    console.log(current.name);
    current.children &&
      current.children.forEach((child) => {
        stack.push(child);
      });
    current = stack.shift();
  }
}
let root = {
  name: "A",
  children: [
    {
      name: "B",
      children: [{ name: "B1" }, { name: "B2" }],
    },
    {
      name: "C",
      children: [{ name: "C1" }, { name: "C2" }],
    },
  ],
};
bfs(root); // A B C B1 B2 C1 C2
js
// 数组的情况
function bfs(root) {
  root &&
    root.forEach((node) => {
      const stack = [];
      stack.push(node);
      let current = stack.shift();
      while (current) {
        console.log(current.name);
        current.children &&
          current.children.forEach((child) => {
            stack.push(child);
          });
        current = stack.shift();
      }
    });
}

let root = [
  {
    name: "A",
    children: [
      {
        name: "B",
        children: [{ name: "B1" }, { name: "B2" }],
      },
      {
        name: "C",
        children: [{ name: "C1" }, { name: "C2" }],
      },
    ],
  },
  {
    name: "A1",
    children: [
      {
        name: "B1",
        children: [{ name: "B11" }, { name: "B21" }],
      },
      {
        name: "C1",
        children: [{ name: "C11" }, { name: "C21" }],
      },
    ],
  },
];

bfs(root);
DFS 与 BFS 遍历对比
以下面这棵树为例,对比两种遍历的访问次序:
text
          A
        /   \
       B     C
      / \   / \
B1 B2 C1 C2- DFS(深度优先):A → B → B1 → B2 → C → C1 → C2(沿分支纵向深入,借助栈/递归)
- BFS(广度优先):A → B → C → B1 → B2 → C1 → C2(逐层横向扩散,借助队列)
结语:结构与算法的选择哲学
数据结构与算法的核心,是理解每种工具的「擅长与代价」:
- 查找快选哈希表/数组,增删快选链表——本质是连续内存与指针的取舍;
- 有嵌套/回溯用栈与 DFS,有分层/最短路用队列与 BFS——本质是 LIFO 与 FIFO 的取舍;
- 有序数据善用二分查找与 BST——用 O(log n) 换取排序/维护平衡的成本。
没有银弹,只有权衡。把这些「时空取舍」的直觉内化,才能在真实工程中选对结构、写出高效代码。